Привет! Меня зовут Кирилл Мозолев, я руководитель портфеля ИИ-продуктов в red_mad_robot, один из которых — red_mad_router. Когда мы с командой строили мультиагентные системы в наших проектах, мы столкнулись с интересной задачей: как эффективнее направить пользовательский запрос к нужным агентам? Как правило, при создании мультиагентных систем разработчики по умолчанию пользуются роутером-агентом на базе LLM, не подвергая такой подход сомнению. Мы же решили узнать на практике, какие существуют альтернативы для этого метода.
Расскажу, как мы проверяли гипотезу: может ли агент с обучением с подкреплением (RL) научиться роутингу в мультиагентной системе. А ещё делать это лучше, быстрее и дешевле, чем LLМ. Заодно поделюсь, при чём тут Пакман и игры от Atari.
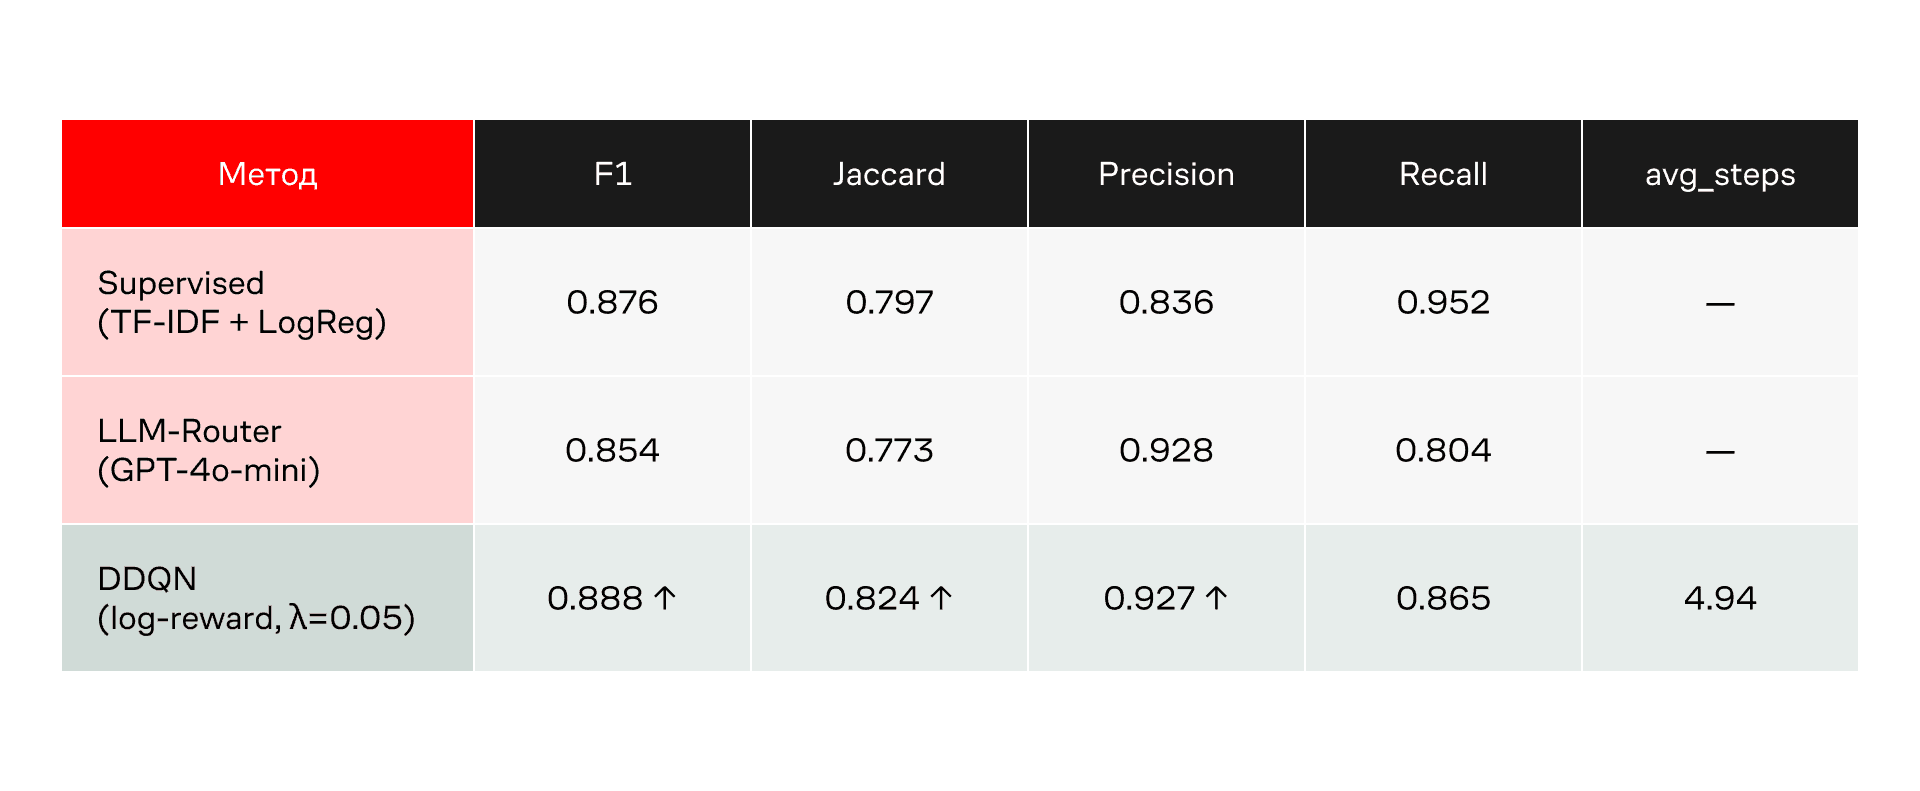
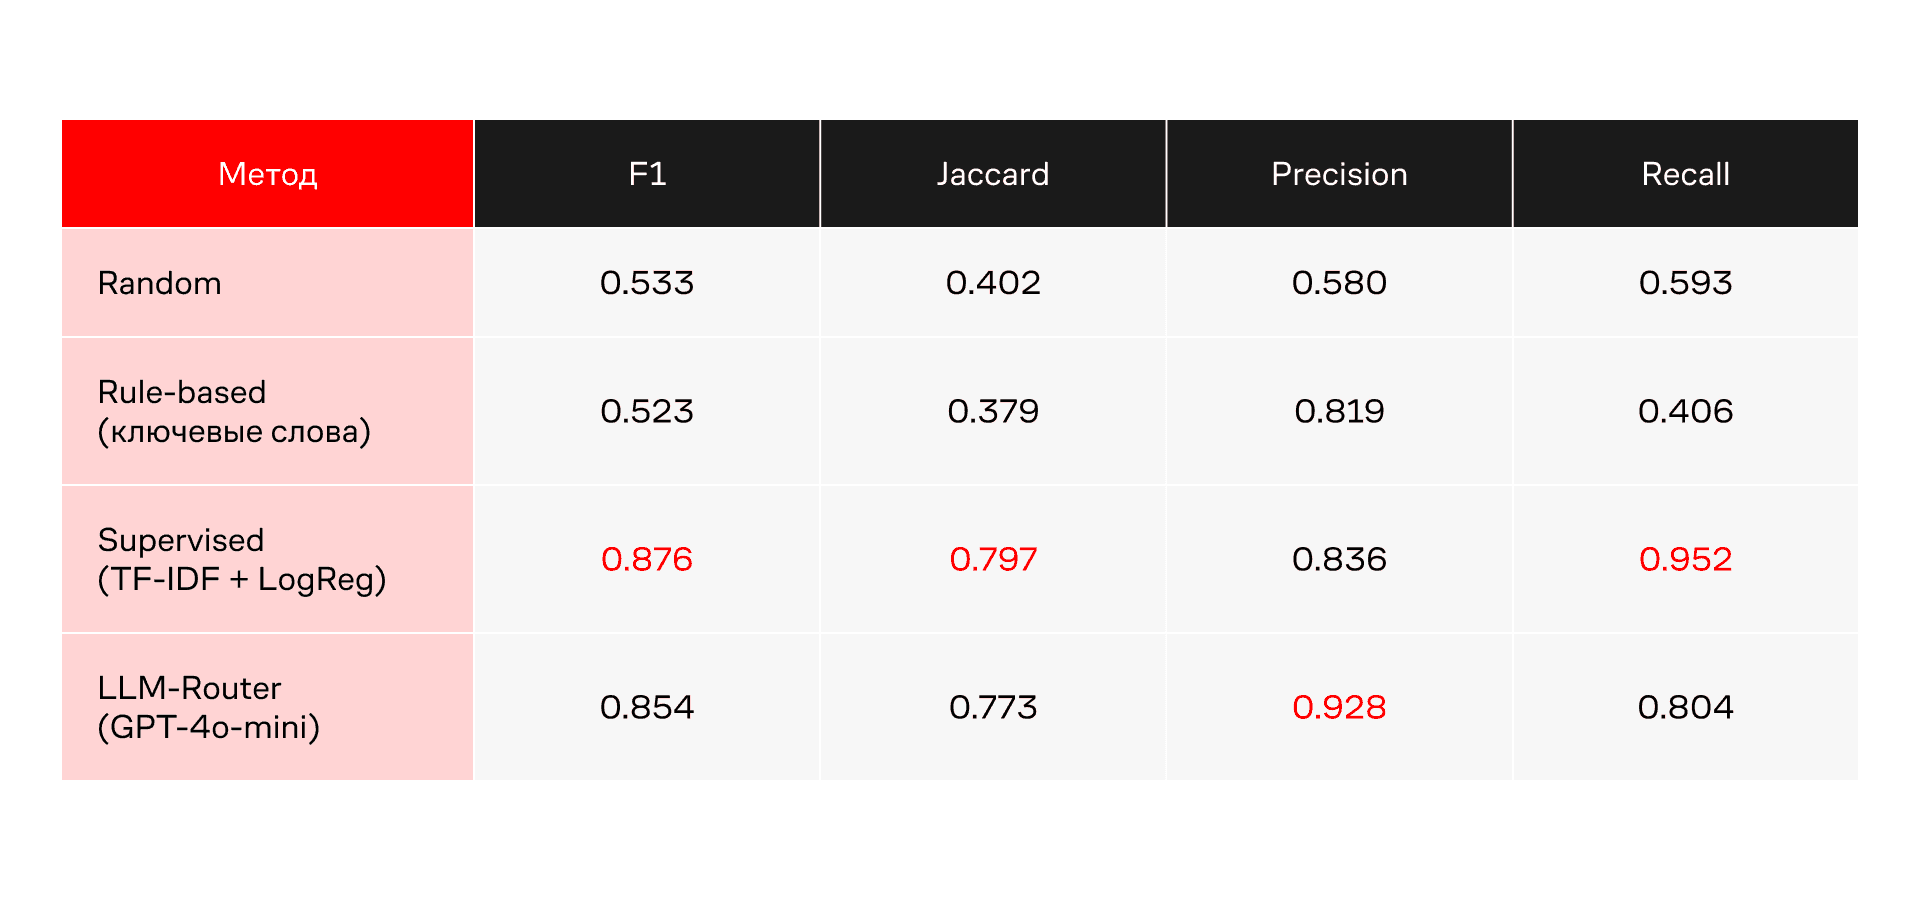 Взглянем на метрики. Rule-based роутер внезапно показал результаты даже ниже, чем случайный подбор в Random. Но не потому, что правила «плохие», а потому, что у него провал по recall — он выбирает мало агентов. Мультиметочный классификатор (TF-IDF + OneVsRest LogReg) оказался неожиданно сильным: F1 = 0.876, recall = 0.952. LLМ-роутер показывает сопоставимый F1 при значительно лучшем precision, но проигрывает по recall.
Цель у DDQN — превзойти лучший результат по F1, сохранив разумный баланс precision/recall.
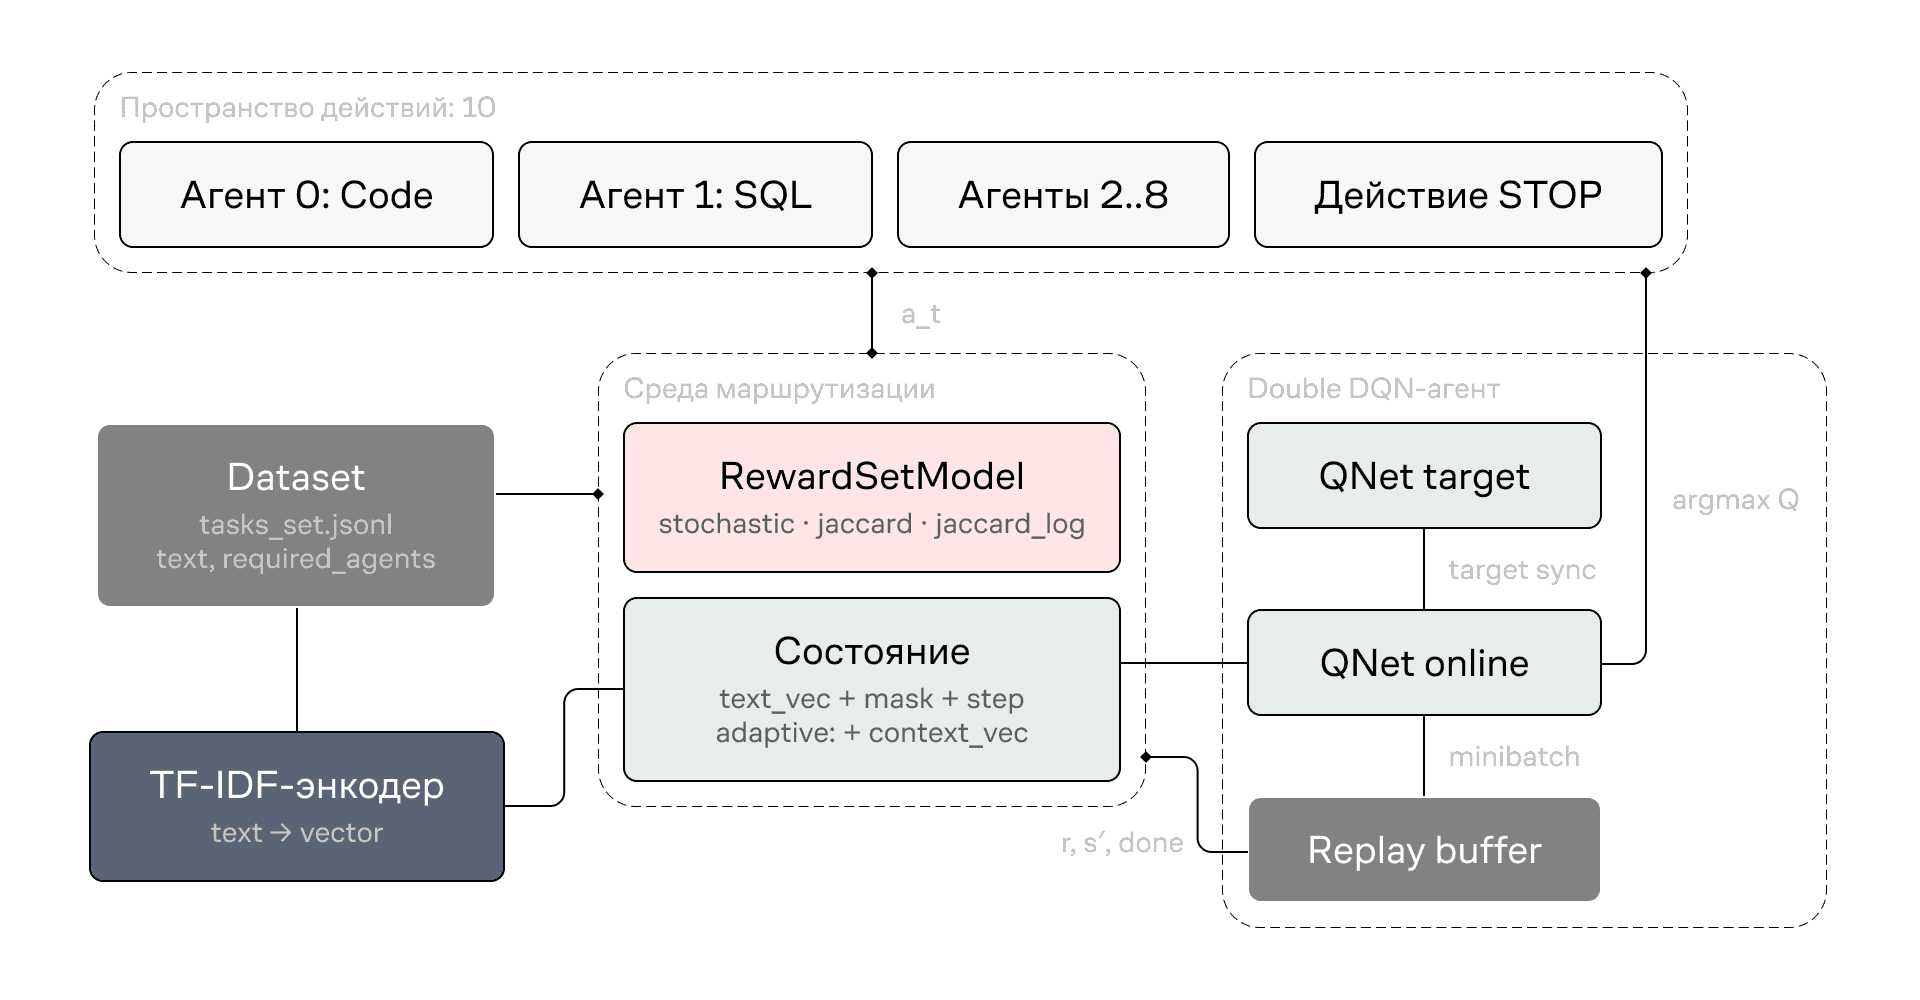 Пайплайн работы роутера
На вход Q-сети поступает не только представление пользовательского запроса, но и информация о том, какие агенты уже были выбраны ранее. Благодаря этому роутер принимает решения последовательно. Каждый следующий шаг зависит от предыдущих, а состояние обновляется после каждого выбора. Для обучения используется replay buffer на 100 000 переходов, а размер batch — 128.
Один эпизод работы роутера можно представить при помощи такой схемы:
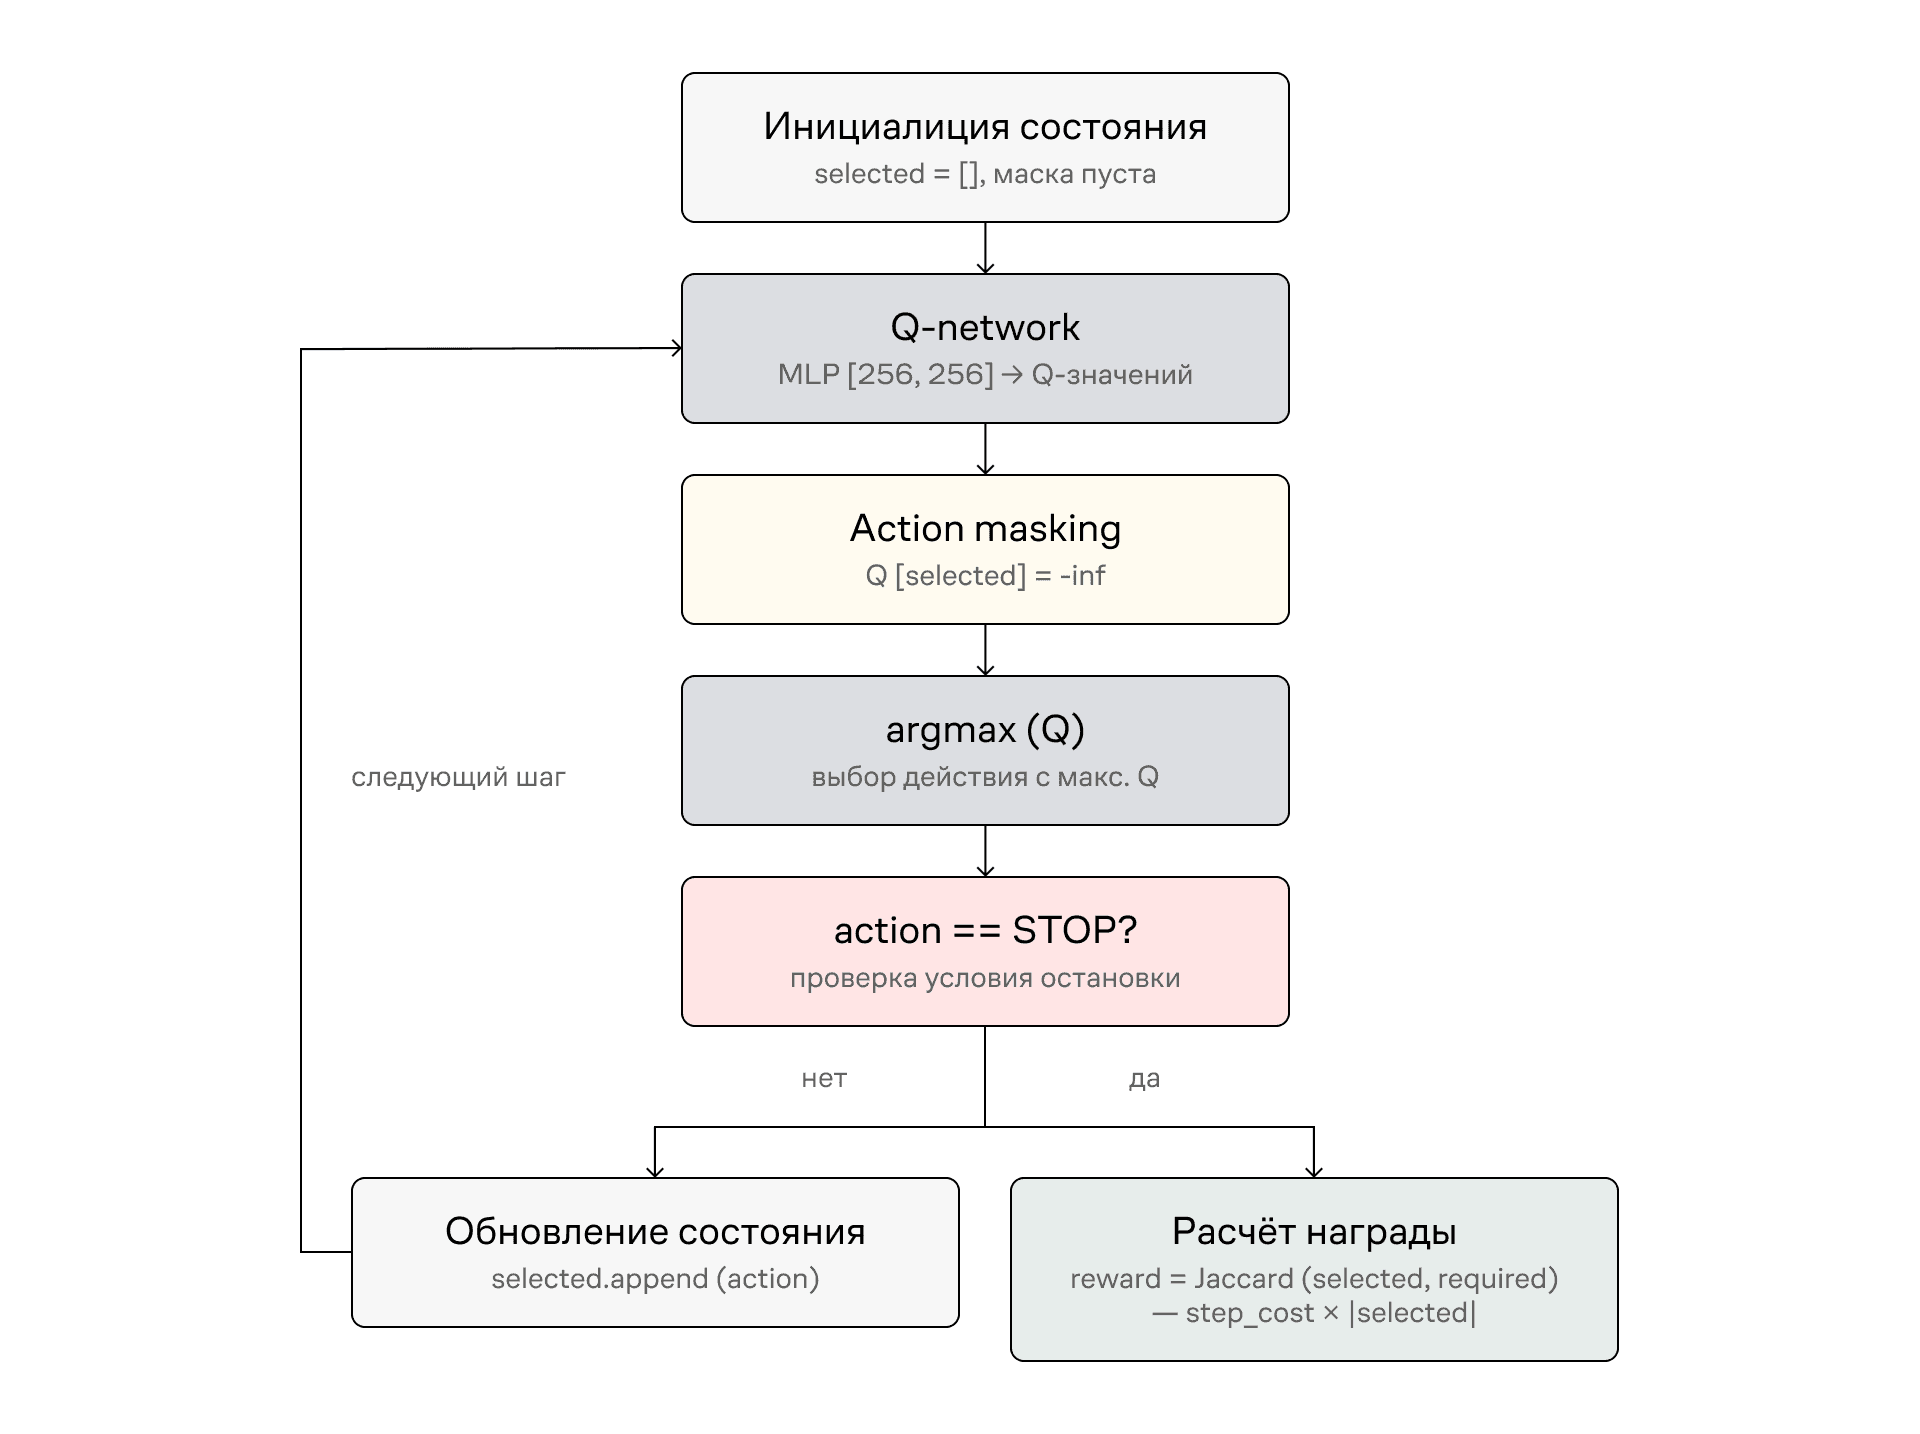 Схема работы одного эпизода роутера
На первом шаге состояние содержит только описание запроса и пустую маску выбранных агентов. После каждого действия маска обновляется, поэтому сеть уже «видит», какие агенты были добавлены ранее, и может учитывать их при следующем выборе. Сеть не выбирает агентов повторно, а последовательность действий формирует итоговый набор маршрутизации.
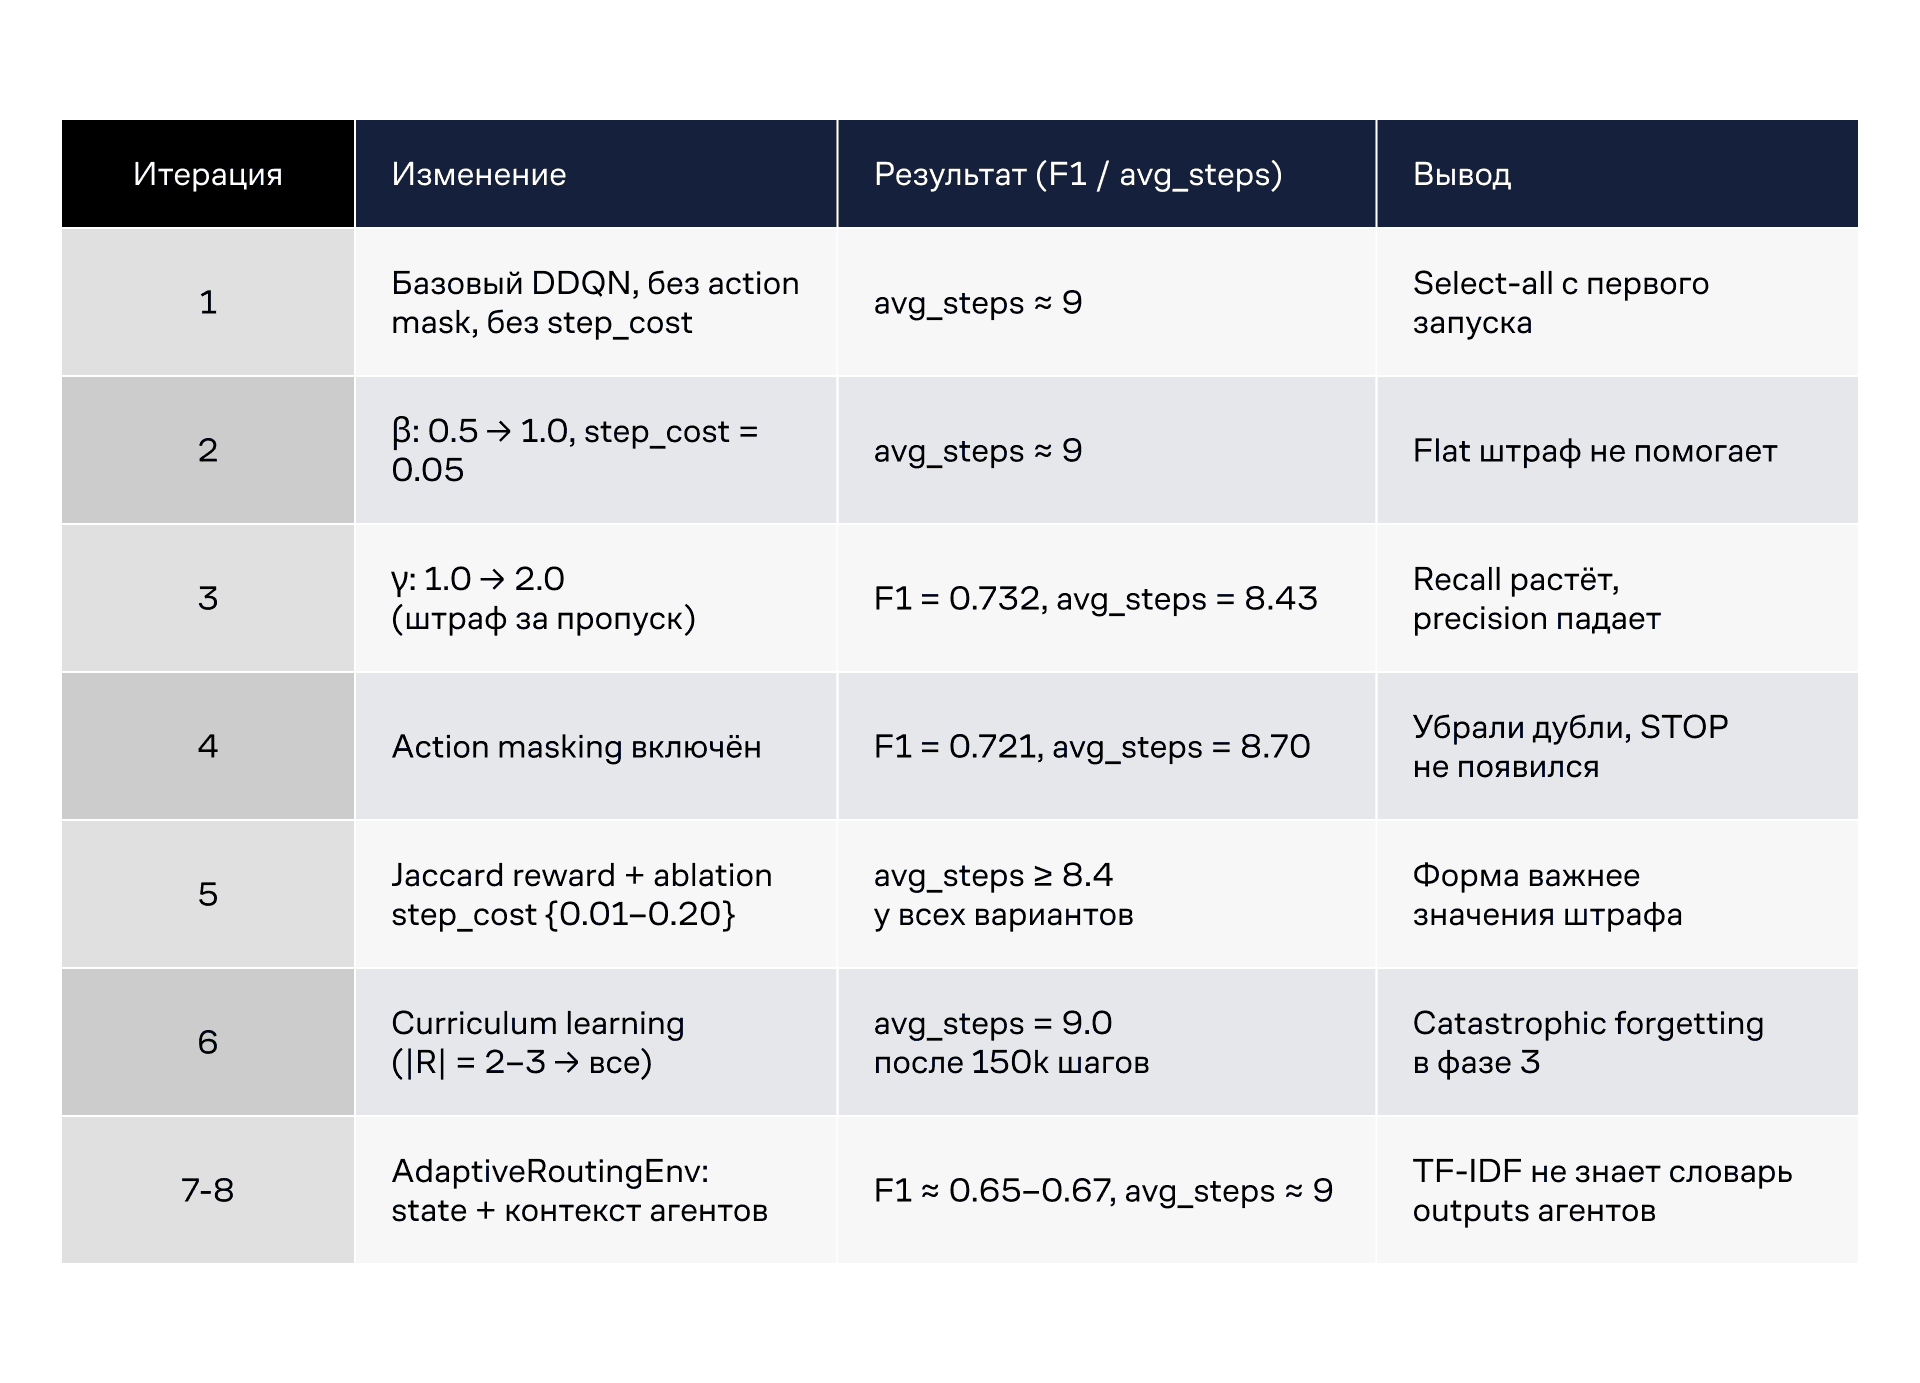 Особых улучшений не происходило, каждое новое изменение не поднимало результат. Настоящий прорыв случился только на девятой итерации, когда стало понятно, что нужно менять не уровень штрафа, а его геометрию во времени.
Идея пришла из статьи Puppeteer. Штраф за шаг не должен быть постоянным — он должен расти с каждым следующим шагом.
Формула награды выглядит так:
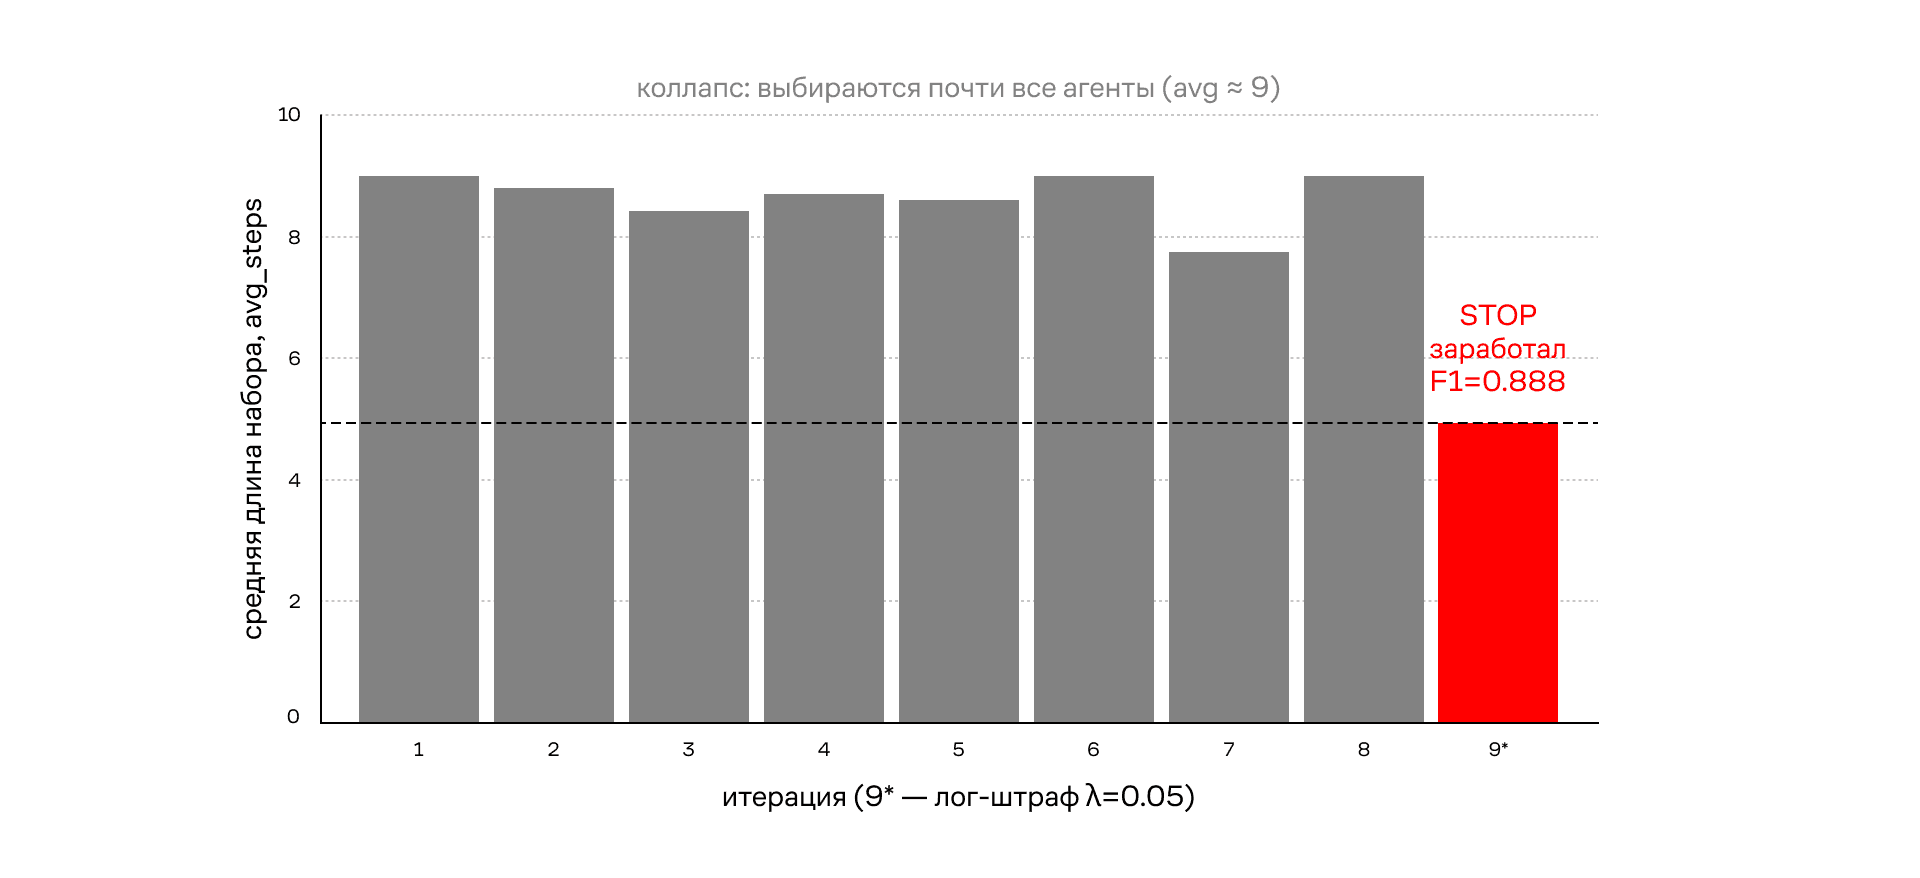 Средняя длина выбранного набора (avg_steps) по итерациям. Пунктир — среднее |R| в датасете.
Дополнительно критичным оказался epsilon schedule. Когда
 Сравнение подходов по различным метрикам
DDQN с логарифмическим штрафом (λ = 0.05) показал лучшие F1 (0.888) и Jaccard (0.824) среди всех методов, опережая Supervised по F1 совсем немного, но с заметно более высокой precision (0.927 против 0.836) и меньшим набором агентов (4.94 против 6.16). Его главное преимущество – сопоставимое или лучшее качество с учётом фактически бесплатного инференса, при latency ~1 мс и без внешних API.
Проблема: куда отправить запрос?
Когда строишь мультиагентную систему, рано или поздно упираешься в задачу роутинга: нужно решить, какой из агентов обработает входящий запрос пользователя. Однако иногда один запрос требует сразу нескольких агентов одновременно. Тогда приходится искать целый набор подходящих агентов. Формально это задача выбора подмножества: на входе — текстовый запрос, на выходе — подмножество S агентов, которое должно максимально совпасть с эталонным набором R. Качество измеряем коэффициентом Жаккара (Jaccard similarity): |S ∩ R| / |S ∪ R|. Для её решения есть множество подходов, но для сравнения со своим методом, я взял следующие из них:- Правила на ключевых словах. Простые и быстрые, но они плохо масштабируются. Правило
if «SQL» in query → SQL Agentне учитывает контекст и не может выбрать несколько агентов по косвенным признакам. - Мультиметочный классификатор. Работает, но принимает решение один раз и независимо по каждому агенту. Не учитывает, каких агентов уже выбрали.
- LLМ-роутер. При миллионе запросов в месяц он обходится примерно в $150 только на роутинг (gpt-4o-mini, ~1000 токенов на промпт). Сюда же прибавим 0.5–1 с latency на каждый вызов, которая ложится поверх времени работы самих агентов.
При чём тут MDP
Выбор агентов — это последовательный процесс. В моём исследовании пул состоял из 9 специализированных агентов: Python-код, SQL, анализ данных (Pandas), математика, извлечение JSON, суммаризация, ТЗ/требования, рерайт под стиль и финансовые расчёты. Роутер-агент смотрит на запрос, выбирает первого агента, смотрит на уже выбранных, выбирает следующего, и так до тех пор, пока не решает остановиться. Это классический MDP — Марковский процесс принятия решений (Markov Decision Process):- Состояние (state): TF-IDF-вектор запроса + бинарная маска уже выбранных агентов + доля пройденных шагов t/T.
- Действие (action): один из ещё не выбранных агентов или STOP — итого N+1 = 10 действий для нашего пула из 9 агентов.
- Награда (reward): в конце эпизода — коэффициент Жаккара между выбранным и эталонным набором; плюс небольшой штраф за каждый шаг, о форме которого — ниже.
DQN и Double DQN: что выбрать
Одним из базовых алгоритмов в обучении с подкреплением является DQN (Mnih et al., 2015). Его первым большим бенчмарком стали игры Atari 2600 — в том же наборе была и знаменитая игра Ms. Pac-Man. Когда Пакман съедает точку, он получает очки, но, попадаясь призраку, теряет жизнь. Так же и DQN: агент учится по награде от среды, не зная правил заранее. Среда выдаёт награду за положительный результат и штраф за отрицательный, а нейросеть учится предсказывать, сколько награды принесёт каждое действие — Q-значение. Однако стандартный DQN систематически завышает Q-значения: он использует одну сеть и для выбора действия, и для его оценки. В задаче с разреженным вознаграждением, когда оно появляется только в конце эпизода, это особенно критично. Double DQN решает проблему разделением ролей. Online-сеть выбирает действие, target-сеть оценивает его Q-значение. Поэтому для нашей задачи с выбором набора агентов я остановился на этом подходе.Четыре baseline перед стартом
Перед тем, как обучать RL-агента, я зафиксировал четыре бейзлайна на одном датасете. В качестве основного метода я взял Supervised, который мы должны превзойти по F1 Score. При этом как нижний бенчмарк мы берём Random — ниже него падать нельзя.Архитектура
На схеме ниже изображён полный путь, который проходит запрос пользователя внутри DDQN-роутера, от текста до финального набора выбранных агентов.9 итераций: хронология исследования
Для того, чтобы DDQN начал показывать результаты лучше других методов, ему пришлось пройти 9 итераций исследования. Первые восемь итераций объединяла одна проблема: агент не учился нажимать STOP. Вместо этого он выбирал сразу весь пул доступных агентов. Возникает эта ситуация так. Если награда (reward) равнак оэффициенту Жаккара (Jaccard), то каждый дополнительный агент из нужных даёт прирост ~0.05–0.10 к Jaccard. Любой flat-штраф за шаг (step_cost), который меньше этого прироста, агент игнорирует. Агенту выгоднее перебрать всех, чем рискнуть пропустить нужного. Назовём это select-all коллапсом. Вот так я пытался решить эту проблему в течение восьми итераций:reward = Jaccard(S, R) − λ · Σ ln(1 + t/9), где t — номер шага от 1 до 9, λ = 0.05.
epsilon_decay_steps = total_steps, replay buffer заполняется «мусорными» эпизодами с длинными случайными траекториями, и Q-сеть обучается не на тех данных. Я вывел правило: epsilon_decay_steps = 50 000, независимо от total_steps.
Обязателен также action masking, убирающий повторы и ускоряющий сходимость. Без него агент тратит ёмкость Q-сети на паттерны, которые никогда не должны встречаться.
Также стоимт отметить, что была еще одна итерация с проверкой adaptive-ветки. В состояние я добавлял контекст промежуточных выходов уже вызванных агентов. По моей гипотезе, обратная связь должна была усилить роутер. Но результат вышел противоположным: F1 упал до 0.67, а select-all вернулся. Причина тут в энкодере — TF-IDF, обученный на пользовательских запросах, не знает словарь outputs агентов и превращает контекст в почти нулевой сигнал. К этому ограничению вернусь ниже.
DDQN и другие подходы
Результаты, которые показал DDQN после девяти итераций исследования, я также сравнил с другими методами.Использование и ограничения
DDQN показывает хорошие результаты в сравнении с остальными методами, но в его использовании есть нюансы. Метод подойдёт, если:- есть 3+ специализированных агента и нужен subset routing: один запрос → несколько агентов;
- есть ≥ 500 примеров для разметки; оптимально — 2000;
- распределение запросов стабильно.
- меньше ~300 примеров: в таком случае проще использовать keyword-matcher или прямой LLМ-вызов;
- нужен single-agent routing: здесь справится и обычный классификатор;
- состав агентов меняется часто, минимум раз в неделю, и каждое изменение требует переобучения. Впрочем, в DDQN-роутере есть инструмент разметки на базе LLМ. С его помощью переобучение можно сделать максимально автоматизированным, хотя избежать его совсем не получится.
Библиотека ddqn-router
Разработку можно опробовать уже сейчас. Результаты исследования я упаковал в open-source библиотеку ddqn-router. А здесь можно посмотреть основные команды для установки и использования. Описание агентов:# config.yaml
agents:
- id: 0
name: "Billing Agent"
description: "Handles billing, invoices, payments"
- id: 1
name: "Technical Agent"
description: "Handles bugs, errors, <Aitip>API</Aitip> issues"
# 1. Разметить датасет через <Aitip>LLM</Aitip> (один раз)
ddqn-router label --config config.yaml --input queries.txt --output data/tasks.jsonl

# 2. Обучить роутер
ddqn-router train --config config.yaml

# 3. Использовать
from ddqn_router import DDQNRouter

router = DDQNRouter.load("./artifacts/")
result = router.route("my invoice was charged twice")
print(result.agents)       # [0, 2]
print(result.confidence)   # 0.87
print(result.steps)        # 3
ddqn-router serve --artifacts ./artifacts/ --port 8000